
Anthropicが社内データ質問をAIで自動回答する運用法を公開しました。
Anthropicの公式ブログは2026年8月13日、社内のSlack上でデータに関する質問をAIが直接答える仕組みの運用ノウハウを公開しました。同社のあるデータ関連チャンネルでは、直近1か月に投稿された質問の75%以上に、AIが名指しで呼ばれなくても自ら回答し、多くは1〜2分以内に返しているといいます。不動産のデータ分析AIを検討する立場から読むと示唆が濃いのは、精度そのものではなく、権限設計と情報の鮮度が記事の中心に据えられている点です。本記事は、宅建業免許(東京都知事(1)第113520号)を保有し、AI導入コンサル100社超の実績を持つ株式会社オルセル(不動産のチカラ運営)が解説します。
何が起きたか:チャットが「データ分析の窓口」になった
結論から書くと、今回公開されたのは新しいAIモデルではなく、既存のデータ基盤をチャットに接続するときの運用作法です。Anthropicは以前の記事で、社内のデータ質問に約95%の正答率で答えさせるために、定義を統一した意味レイヤー、分析の作法を書き下したスキルファイル、そして精度を測る評価スイートという3点を整備したと説明していました。今回はその土台を、分析担当者ではない全社員が使うSlackへ持ち込むための話です。
使われているのはClaude Tagというパブリックベータの機能で、チャンネル内で呼びかけるとデータの質問に答えます。特徴は、回答が分析担当者と同じ「統制された定義」に基づく点です。ある社員がダッシュボードに新しい区分が含まれているかを公開チャンネルで尋ねたところ、90秒以内に定義を説明し、区分が漏れていることを確認し、修正案とコードの変更まで下書きした、という例が挙げられています。
同社が挙げた学びのうち、不動産のデータ分析AIにそのまま効くのは3つです。1つ目は、スキルファイル(AIに手順や定義を教えるテキスト)を一度作って終わりにせず、データ定義が変わるたびに更新し、会話のたびに読み直させること。列名が変わっただけでも、古い定義を読んだAIは「先週の間違った答え」を自信満々で返します。2つ目は、集計方法だけでなく、予測、コホート分析、ファネル分析、作図、書き方の作法まで手順として与えること。3つ目は、数字が動いた理由を説明させるために、データベースだけでなく社内の議論や障害記録も参照させることです。
日本の不動産事業者にとっての論点は、精度より権限設計
日本の不動産事業者がこの仕組みを持ち込むとき、最初に決めるべきは精度ではなく権限です。記事のなかで最も重い指摘は、AIが倉庫(データベース)に接続するとき、質問した本人ではなくサービスアカウントとして問い合わせるため、そのアカウントが読める範囲は、チャンネルにいる全員が実質的に読める範囲になる、という点でした。ユーザーごとの行単位の制御はかからないという前提です。
これは不動産業では致命的になり得ます。賃貸管理会社のデータには、入居者の氏名、電話番号、勤務先、保証会社の審査結果、滞納履歴、口座情報が混在します。仲介会社の顧客管理には、反響時の年収帯や家族構成が残っていることも珍しくありません。営業部門のチャンネルにAIを招いた結果、本来アクセス権のない社員が滞納履歴を自然文で引き出せる状態になれば、個人情報の目的外利用や安全管理措置の不備として問われる余地があります。取り扱いの原則は個人情報保護委員会の公表資料で確認しておくべき領域です。
Anthropicはこの問題に対し、サービスアカウントが読めるのは検証済みの集計テーブルだけに限り、生ログや作業用の領域は読ませない、個人情報に当たる列を列単位で分類してサービスアカウントには閲覧権限を与えない、という順序で対処しています。つまり、テーブル自体は問い合わせられるが、氏名や連絡先の列だけが物理的に見えない状態を作るということです。さらに、AIをチャンネルに追加する行為そのものを「アクセス権の付与」とみなし、追加できる人をデータ部門に限定しています。この設計思想は、日本の不動産会社が自社の顧客データをAIに触らせる際の実務基準として、そのまま流用できます。関連する法令面の整理は不動産AIと個人情報保護法の実務にまとめています。
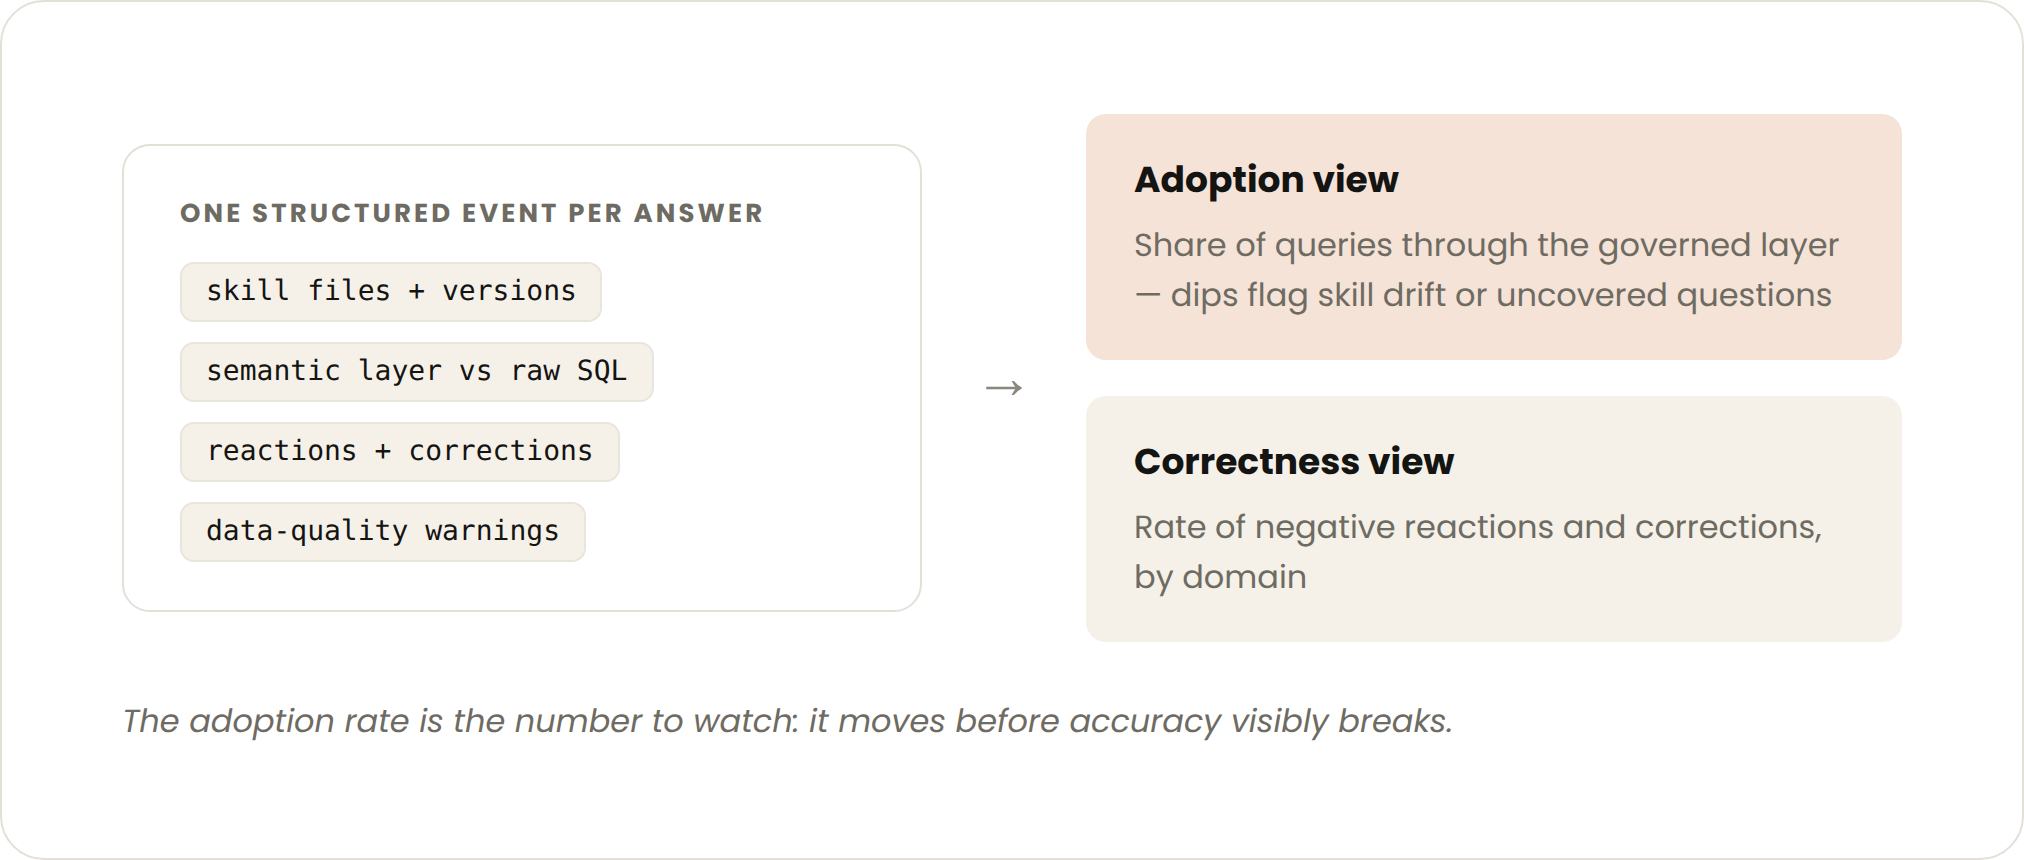
もう一点、日本の不動産会社に効くのが「答えを必ず計測する」という姿勢です。同社はすべての質問について、どのスキルファイルをどの版で読んだか、利用者が親指の上下で反応したか、訂正を書き込んだか、触れたテーブルにデータ品質の警告が出ていなかったかを記録しています。そこから、質問のうち統制されたデータ経由で答えられた比率と、否定的な反応や訂正の比率という2つの指標を見ています。前者が下がったときは、定義がずれたか、想定外の質問が増えたかのどちらかだと判断しているとのことです。管理戸数や成約数のように定義が会社ごとに揺れる指標を扱う不動産業では、この2指標の設計が導入の成否を分けます。
不動産会社が今日から始められる4つの初動
最初にやるべきは、AIに読ませてよいデータの線引きです。物件マスタ、空室状況、反響件数、成約件数といった「人名が入らない集計」と、入居者台帳や審査記録のような「個人が特定できるデータ」を分け、後者は接続対象から外します。理想を言えば列単位で分類しますが、まずはテーブル単位でも構いません。
次に、社内で使っている指標の定義を1枚のテキストに書き下すことです。稼働率の分母は管理戸数か募集戸数か、成約日は契約日か入金日か、反響は電話とメールとポータル経由を合算するのか。こうした定義は担当者の頭の中にあることが多く、書かれていない定義はAIが勝手に埋めます。自社データでAIの回答品質を測る考え方は自社データでAIモデルを比較検証する手順で扱っています。
三つ目に、チャンネルの設計です。誰がAIを招待できるかを決め、招待は情報システム担当か管理職に限定します。営業担当が自分の判断でAIを別チャンネルに招く運用になると、権限の線引きが1週間で崩れます。
四つ目に、質問と回答のログを残す仕組みです。誰がいつ何を聞き、AIがどのデータを見て答えたかを追えないままでは、誤った数字が資料に転記されたときに原因を特定できません。なお、レインズから取得したデータをAIに読ませてよいかは、指定流通機構の利用規約と個別の運用ルールに依存するため要確認の領域です。物件データ側の整理はレインズのAI分析と物件データ活用を参照してください。
まとめ
Anthropicが示したのは、データ分析AIをチャットに置く価値は速さ(90秒で回答)にあるが、その速さを安全に成立させているのは権限設計と定義の鮮度だ、という順序でした。不動産のデータ分析AIを検討するなら、まず個人情報を含む列を接続対象から外し、自社の指標定義を文章化し、AIを招けるチャンネルと人を絞る。この3条件を先に固めてから、便利さの話に進むのが現実的です。
参考文献
- Claude by Anthropic「Self-service data analytics in Slack: how Anthropic deploys Claude Tag for ad-hoc questions」
- Claude by Anthropic「How Anthropic enables self-service data analytics with Claude」
- Claude by Anthropic「Agent identity and access model」
- Anthropic「Claude Tag」製品ページ
- 個人情報保護委員会
※不動産のチカラでは、生成AIの導入支援から運用最適化まで、貴社の不動産事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://fudosannochikara.jp/contact/
引用元: Claude by Anthropic
【監修】齋藤竹紘(株式会社オルセル代表 / EC支援19年5,000社超・AIコンサル100社超 / 宅建業免許 東京都知事(1)第113520号)